顯示具有 數學 標籤的文章。 顯示所有文章

2020年11月5日 星期四

Spherical Gaussian (2)

  • 前言


在上一篇,簡單介紹了一維 Gaussian Function , 


在本篇,將會介紹在圖形渲染所使用的 Spherical Gaussian ,


作為後面章節應用的基礎知識。


  • Spherical Gaussian

Spherical Gaussian 的定義如下


其中:

v:求得 Spherical Gaussian 結果的三維方向輸入參數;對渲染物體而言,可視為來源光的方向

p:lobe axis;對渲染物體而言,可視為該點的法向量

λ:lobe sharpness;一個範圍在 [0, ] 的一維參數,控制 lobe 的形狀,越大越尖銳

μ:lobe amplitude;對渲染物體而言,可視為該點的顏色值(RGB)

和一維 Gaussian Function 一樣

Spherical Gaussian 提供了 λ 和 μ 兩個參數來控制輸出的形狀。

λ=10時,μ對 lobe 形狀的影響


μ=1時,λ對 lobe 形狀的影響


在數學上,Spherical Gaussian 有著下述特性

1. 兩個 Spherical Gaussian 相乘結果仍為 Spherical Gaussian


2. Spherical Gaussian 積分為一個 closed-form


3. 兩個 Spherical Gaussian 的 inner product (內積) 也是一個 closed-form


回想我在 淺談 physically based rendering (1) 提到的渲染方程式


上述提到的 Spherical Gaussian 可以有效率地去處理複雜的 hemispherical integration,

這代表著,我不必去取大量的樣本數就可以直接得到積分結果。


  • 結論

Spherical Gaussian 雖然算是個比較冷門的話題,但 Ready At Dawn 工作室卻對其情有獨鍾,

並使用在其自製遊戲引擎,其效果也在遊戲 The Order:1886 得到了驗證。

最近不只歐美,連日本也開始對 Spherical Gaussian 開始研究,

相信 Spherical Gaussian 應該會逐漸地受到注目,尤其是在注重效能的移動裝置上。

本篇對 Spherical Gaussian 的介紹就到此結束,

下一篇將討論 Spherical Gaussian 在 Physically based rendering 的應用。 


  • References
  1. "All-Frequency Rendering of Dynamic, Spatially-Varying Reflectance” Jiaping Wang, Peiran Ren, Minmin Gong, John Snyder, Baining Guo. SIGGRAPH ASIA 2009
  2. The Danger Zone, Matt Perrineo
  3. 球面ガウス関数を極める -動的間接照明の高速近似- CEDEC 2015 (2015),株式会社スクウェア・エニックス,德吉 雄介

2020年10月30日 星期五

Spherical Gaussian (1)

  • 前言

Gaussian Function (高斯函數)是一個被廣泛應用在各個領域的數學函式。

在統計學、訊號處理、自然科學及工程學等領域都可以看到它的身影。

本主題將分成數篇文章討論 Gaussian Function,從一維到球面。

最後介紹在圖像渲染的應用


  •  Gaussian Function
一維 Gaussian distribution (高斯分布,又稱常態分布) 可以用下列的數學方程式來表示


其中: 

σ 是 standard deviation (標準差 )

μ 是 expected value (期望值,對機率分布而言 常稱為平均值)

從圖表來看,會呈現一個 bell curve (鐘形曲線)。

σ=0.2, μ=0 的Gaussian distribution曲線

Gaussian distribution 最大的特徵,就在於可以畫出左右對稱的 bell curve。

仔細觀察 Gaussian distribution ,發現方程式可以由三個部份來控制輸出形狀。


因此,做為一個 bell curve 的輸出函數,Gaussian Function 可以改寫成下圖所示:


其中:

參數 a 控制曲線峰值

b=0, c=1 的Gaussian function曲線

參數 b 控制曲線中心位置

a=1, c=1 的Gaussian function曲線

參數 c 控制曲線平滑度

a=1, b=0 的Gaussian function曲線

  • 結論
本篇簡單的介紹一維 Gaussian Function 作為引導,了解各參數對輸出形狀的影響。

在下一篇會開始進入 Spherical Gaussian 的討論,並說明在圖像渲染的應用。

2020年5月1日 星期五

Low-discrepancy sequence (準亂數列)


  • 前言
在上一章介紹了如何使用一個2維變數 (ξ12)來得到一個 GGX 分布的法線向量,

在這裡衍生了一個問題,

要如何找到一個合適的2維變數陣列作為積分用的採樣點的法線向量。

本章節就是介紹使用 Low-discrepancy sequence (準亂數列) 

作為 Quasi Monte Carlo Method 取樣點的優點與實作方法。


  • Monte Carlo Method
Monte Carlo Method 是使用亂數取樣點作為積分計算的數列,

若使用 N 個樣本數,則他的積分誤差的收斂速度為 O(N−0.5)[1]

這代表著如果我要提升2倍的精度,我需要提供4倍的樣本數。


  • Quasi Monte Carlo Method
不同於 Monte Carlo Method 使用亂數列作為採樣點,

 Quasi Monte Carlo Method 使用了 Low-discrepancy sequence 作為採樣點,

使得其積分誤差的收斂速度為 O(log(N)dim/N), 其中 dim 為 dimension(次元數)。

這代表著如果在 2 維空間使用 Quasi Monte Carlo Method 做積分,

要提升2倍的精度,只需要提供2倍的樣本數。

因此可以得知若在低次元空間下做積分,

Quasi Monte Carlo Method 比 Monte Carlo Method 有著更高的收斂速度。


  • Hammersley Sequence
回到了一開始的問題,如何找到一個合適的2維變數陣列作為積分用的採樣點的法線向量。

在這裡就是使用 Quasi Monte Carlo Method,

利用 Low-discrepancy sequence 找出採樣點陣列做積分計算。

本章節接下來會說明並實作一個常用的 Low-discrepancy sequence,

也就是 Hammersley Sequence。


基本理論很簡單


我給定一個索引值 α,先將其轉為2進制,

再依序將2進制的每個位數由後往前依序放入小數點後,在由前往後乘以2的倒數,

就是回傳結果。

ex.

0.1     = 1 * 2−1 = 0.5
0.01   = 0 * 2−1 + 1 * 2−2 = 0.25
0.11   = 1 * 2−1 + 1 * 2−2 = 0.75
0.001 = 0 * 2−1 + 0 * 2−2 + 1 * 2−3= 0.125
...

如此可以得到一個在 [0,1] 數列。

下圖為  Hammersley Sequence 的2維採樣結果


從上圖可知,這是一個非隨機的數列,

但是它的結果分布卻是有著微小差異(不知情的人可能會認為他是一個隨機採樣結果)。

這種數列就叫做 Low-discrepancy sequence。


2維 Hammersley Sequence 的實作方式如下

float RadicalInverse_VdC(uint bits) 
{
    bits = (bits << 16u) | (bits >> 16u);
    bits = ((bits & 0x55555555u) << 1u) | ((bits & 0xAAAAAAAAu) >> 1u);
    bits = ((bits & 0x33333333u) << 2u) | ((bits & 0xCCCCCCCCu) >> 2u);
    bits = ((bits & 0x0F0F0F0Fu) << 4u) | ((bits & 0xF0F0F0F0u) >> 4u);
    bits = ((bits & 0x00FF00FFu) << 8u) | ((bits & 0xFF00FF00u) >> 8u);
    return float(bits) * 2.3283064365386963e-10; // / 0x100000000
}

float2 Hammersley(uint i, uint N)
{
    return float2(float(i)/float(N), RadicalInverse_VdC(i));
}  


  • References
1. Søren Asmussen and Peter W. Glynn, Stochastic Simulation: Algorithms and Analysis, Springer, 2007, 476 pages

2020年4月30日 星期四

importance sampling (重點採樣)


  • 前言
在 淺談 physically based rendering (1) 所提到的 rendering equation 


從算式可以得知,實作間接光需要去處理 Surface integral over hemisphere (半球積分)。

因此在繼續實作間接光時,必須先理解積分的基本運算。

積分的基本方法大致上在 Monte Carlo method (蒙地卡羅積分法) 都有提到。

本章將深入討論 Monte Carlo method 在渲染領域的應用,

以方便理解在之後的實作部分所做的任何運算。


  • Monte Carlo method
複習一下在 Monte Carlo method (蒙地卡羅積分法)  提到的 Monte Carlo Estimator

函數 f(x) 在區間 [a,b] 的 Monte Carlo Estimator

這裡我將積分範圍改成 [0, Ω] (Surface integral over hemisphere),

則函數 f(x) 的 Monte Carlo Estimator 為


若區間內的發生機率不同,則 Monte Carlo Estimator 可改寫成


p(xi) 是取樣點 xi 的 probability density function (簡稱 pdf)

根據 Law of Large Numbers (大數法則) 得知,當採樣數越多,越接近真實結果。

但實際上, 採樣數越多,計算的負擔也就越大。


回頭觀察 Monte Carlo Estimator ,積分值是由每個採樣點的 f(xi) / p(xi) 相加逼近。

這裡面勢必會存在某些採樣點  f(xi) / p(xi) 值對於最後的結果影響很小,

同樣地,也勢必會存在某些採樣點的  f(xi) / p(xi) 值對於最後的結果影響很大,

如果忽略那些影響小的參考點只計算影響較大的參考點部分,

這樣求出來的積分近似值應該不會和真實結果差距太大,且可以減少計算量。

因為只採樣影響大的點,所以又叫做 importance sampling (重點採樣)。

知道了 importance sampling,就下來就是要知道如何找出影響大的採樣點。

這其實可以從使用的 pdf 的分佈形狀來判斷。


圖片來源 : Wojciech Jarosz's Dissertation Appendix A

pdf f 的分布形狀越接近,表示可以使用越少的採樣點來逼近積分結果。

反之,兩者形狀差異越大,就需要更多的採樣點來計算積分結果。

因此如何找到一個合適的 pdf 會是實現 importance sampling 的重要課題。


  • 渲染關聯運用
importance sampling (重點採樣) 可以運用在許多領域上,

在渲染領域上主要是用來計算光線接觸到 Microsurface (微平面) 後的反射方向。

如果接觸的 Microsurface 是完全平滑的話,

光線的反射位置會集中在一個方向(i.e. 鏡面反射)。

反之,反射的方向發散,且每個發散的方向強度不同。


因此在採樣反射光時,為了減少計算負擔,

同樣是選擇影響最大(強度最高)的來計算,來逼近真實效果。


  • Importance sample GGX
在 淺談 physically based rendering (4) ,我使用了 GGX BRDF 作為單一方向光源的 PBR 模型,

為了保持一致性,在處理間接光時,也是使用 GGX BRDF,

因此,針對 GGX BRDF 的反射光採樣法就叫做 Importance sample GGX。


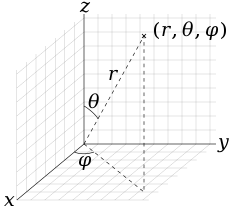
在繼續談論之前,先來了解一下 Spherical Coordinates (球面座標系)


圖片來源 : wikipedia

在 Spherical Coordinates 裡,會使用 3 個參數來代表其座標,寫作 (γ,θ,φ)

其中:

γ : 代表座標到圓心的距離,範圍在 γ 0,因為反射光的方向使用單位向量,所以可以省略

φ : x-y 平面和 x 軸的夾角,範圍在 0φπ

θ : 和 z 軸的夾角,範圍在 0 θ π。但反射光的方向在 hemisphere 內, 範圍在 0 θ π/2

Spherical Coordinates 對應的三維座標 (x,y,z) 為

x = γ * sinθ * cosφ
y = γ * sinθ * sinφ
z = γ * cosθ
0φπ


111111ρ0瞭解了 Spherical Coordinates 之後,回來看 GGX BRDF


因為可以從 D 項(normal distribution function)算出來的法線分布和入射光算出反射光的方向,

所以將焦點集中在 D 項上


為了之後採樣方便,我希望能將採樣的參數限制在 0 ~ 1,

並回傳 Spherical Coordinates 使用的 θ 和 φ 來表示法線的方向。

因此需要使用 Inverse transform sampling (逆變換採樣)來達到目的。

Inverse transform sampling 是透過函數的 pdf  來求得採樣函數。

根據 [4] 可以得知,D 項的 pdf 可以寫成


接著對 φ 積分來求得 θ 的 marginal density function (邊緣密度函數,簡稱 mdf)


再來算出 φ 的 conditional density function (條件密度函數)


最後,計算出 ph(θ) 和 ph(φ|θ) 的 cumulative distribution function (累積分布函數,簡稱 CDF)


到這裡,已經可以知道 θ 和 φ 的關係式為


由於 ξ1 和 ξ2 的範圍都在 0 ~ 1 之間,

因此我可以用一個 2 維的參數 (ξ1 , ξ2) 來取得一個 GGX 分布的法線向量。

這就是  Importance sample GGX

shader 實作的代碼如下
float3 importance_sampling_ggx(float2 xi, float roughness, float3 n)
{
    float a = roughness * roughness;

    float phi = 2 * PI * xi.x;
    float costheta = sqrt((1.0 - xi.y) / (1.0 + (a * a - 1.0) * xi.y));
    float sintheta = sqrt(1.0 - costheta * costheta);

    float3 h = 0;
    h.x = sintheta * cos(phi);
    h.y = sintheta * sin(phi);
    h.z = costheta;

    // 從 tangent space 轉換到 world space
    float3 up = abs(n.z) < 0.999 ? float3(0.0, 0.0, 1.0) : float3(1.0, 0.0, 0.0);
    float3 tx = normalize(cross(up, n));
    float3 ty = cross(n, tx);

    return tx * h.x + ty * h.y + n * h.z;
}
由於 Spherical Coordinates 是屬 tangent space,

因此在實際使用上需要轉換成正常使用的 world space 才行。


  • References

2020年3月2日 星期一

Monte Carlo method (蒙地卡羅積分法)


  • 前言

在這段前間,寫了不少文章來分析電腦圖學的演算法,

但發現,我一直忽略了一個前提,怎麼做積分 ...

之前一直用很隨便的方式來說明 ...

但是仔細想想,還是得要用一個科學的方法來講解,才能夠增加理解。

因此,臨時寫了這篇文章,為之後所談到的演算法實現,做個基礎。


在電腦計算領域中,最常被使用來做積分的方法就是 Monte Carlo method ,

本篇文章就是簡單闡述 Monte Carlo method 原理,以方便之後實作圖學論文中積分的方法。


  • Monte Carlo method

令函式 f(x), x  的範圍 [0,π] , 將其圖示化得到下圖


對函式 f(x)  [0,π] 的範圍內做積分,就是去求得藍色範圍的面積


但說實在,要去做這樣的計算不是一件簡單的事,

因此 Monte Carlo Method 提出了這樣的假設:

令 π 作為矩形的長度,我們可以找到一個常數 h 值,作為矩形的高度,使得


因此,積分就變成了如何找出 h 這個值。

h 這個值,最簡單的方式是在 [0,π] 的範圍內等間距的採樣(我習慣叫他離散採樣),

去計算這些採樣值的平均值,作為 h 。

當樣本數越多,則結果越接近。

因此,用數學式來表示 Monte Carlo method 為


把範圍從範例的 [0,π改寫成任意範圍 [a,b可以得到


這個方程式又稱作 函數 f 的 Monte Carlo Estimator
  • 證明

Monte Carlo method 的證明方式是通過計算 Monte Carlo Estimator 的期望值而得


其中,p(x) 是隨機密度函數(probability density function, 簡稱 PDF)。

簡單來說就是範圍內採樣點x的發生機率。

從上述的算式可以證明 函數 f(x) 的 Monte Carlo Estimator 的期望值

和其積分結果是相等的。

根據 Law of large numbers (大數法則),

當取樣數越多,則結果越接近期望值,

因此,給定足夠數量的取樣點,Monte Carlo Estimator 可以得到積分結果。

  • 隨機密度函數和多元積分

在一開始說明時,我假設範圍區間內每個採樣點的發生率是一致的(在上例為 1 / (b - a)),

但如果每個採樣點的發生機率不一致,則 函數 f(x) 的 Monte Carlo Estimator 改寫成


同樣證明的方法也是計算期望值


Monte Carlo method 也可以簡單運用在多元積分上。


  • 結論

Monte Carlo method 的優點在於他的簡單和方便用於多次元積分的擴充性,

但如何能夠減少採樣數並接近正確值又是另一項課題。

這方面的介紹我會等到應用到這方面的技術時在一併說明。

本章節只要瞭節如何應用 Monte Carlo method 做積分即可


  • 追記
關於積分,研究了一些資料之後,

發現了一個類似的積分方式叫做 Riemann integral (黎曼積分)。

其方法是將積分區間內,分成多個矩形,並將這些矩形面積相加後,可得到積分的近似值。


這些矩形的總和,又稱作 Riemann Sum  (黎曼和)。

和  Monte Carlo method 最大的差別在於,Riemann Sum 是計算每個採樣點間的面積,

之後再累加起來作為積分的近似值。

因此,在不知道取樣點的發生機率時,Riemann Sum 提供了一個簡單方便的方法。